Sistemas RAID #
Introducción#
Las siglas RAID (Redundant Array of Independent Disks, conjunto redundante de discos independientes), hacen referencia a un sistema de almacenamiento que utiliza un conjunto de discos duros independientes organizados para que el sistema operativo los vea como un solo disco lógico. Se pueden combinar discos de varios tipos, por ejemplo se pueden combinar grupos de discos duros mecánicos, grupos de dispositivos de estado sólido (SDD) o grupos de ambos . Almacena los datos de forma redundante.
Los RAID suelen usarse en servidores y normalmente se implementan con unidades de disco de la misma capacidad.
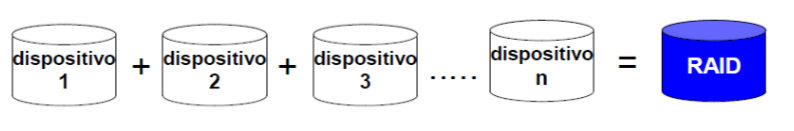
Figura 38. RAID.
Los beneficios de RAID respecto a un único disco duro son: mayor integridad en los datos, mayor tolerancia a fallos, mayor rendimiento y mayor capacidad.
Se mejora el rendimiento ya que permite a varias unidades trabajar en paralelo. La fiabilidad se aumenta mediante dos técnicas: redundancia que implica el almacenamiento de los mismos datos en más de una unidad y la paridad de datos. Esta última consiste en un algoritmo matemático que genera información de paridad, cuando se produce un fallo en una unidad se leen los datos correctos que quedan y se comparan con los datos de paridad almacenados.
El uso de paridad es menos costoso que la redundancia ya que no requiere la utilización de un conjunto redundante de unidades de disco.
El funcionamiento del sistema RAID se sustenta en dos elementos: DATA STRIPPING y PARIDAD. En el Data Stripping (Bandeado o creación de bandas), los datos que llegan al RAID, procedentes del servidor, son divididos por la controladora RAID en segmentos, cuyo tamaño depende del bloque que se defina. Posteriormente, esos segmentos son enviados a los diferentes discos que componen el sistema RAID.
Por otro lado, en el concepto de Paridad, la controladora RAID genera bits de paridad y los almacena en los discos del RAID, obteniendo así la redundancia de datos. De este modo, si un disco falla los datos pueden ser regenerados. La tecnología RAID surge ante la necesidad que existe hoy en día de tener un buen sistema de almacenamiento seguro y tolerante a fallos.
Asegura la integridad de los datos ante la avería de uno de los discos, asegurando un funcionamiento continuo y permitiendo la substitución de una unidad defectuosa sin necesidad de detener los procesos que se están ejecutando. El rendimiento general del sistema aumenta ya que pueden funcionar de forma paralela con los diferentes discos del conjunto. Dependiendo del nivel de RAID que escojamos, si uno de los discos del conjunto falla, la unidad continúa funcionando, sin pérdida de tiempo ni de datos.
La reconstrucción de los datos del disco que ha fallado se hace de forma automática sin intervención humana. En el caso de algunos sistemas operativos la regeneración de datos se hace desde software, aunque en estos sistemas se pueden usar controladoras RAID que sí regenerarían los datos automáticamente. La capacidad global del disco aumentará, ya que se suman las capacidades de los diferentes discos que componen el conjunto.
Para conseguir mejoras en las prestaciones del RAID, se utiliza memoria cache de lectura, que contiene datos de forma temporal, minimizando así el número de accesos necesarios. En la memoria caché de escritura se almacena un determinado número de bloques de datos, adyacentes a ser escritos, disminuyendo de ese modo los accesos a disco. Un sistema de discos RAID es plenamente multi-usuario, ya que todas las solicitudes de los usuarios pueden ser atendidas simultáneamente.
Existen dos tipos de Implementaciones, según la controladora, para los sistemas RAID.
• Las controladoras RAID hardware ofrecen mayores prestaciones y son independientes del sistema operativo, lo cual evita que se pueda generar cualquier tipo de conflicto.
• Por contra, si se emplea un Software RAID para que realice las funciones propias del RAID, se consumirán recursos del servidor. Esto ralentizará su rendimiento. Además, al trabajar con un software específico se depende del sistema operativo, lo cual puede llevar a generar conflictos que deriven incluso en la corrupción de los datos. ¿Qué es mejor: una controladora RAID Interna o Externa? Sin duda es mejor utilizar un sistema RAID externo al servidor.
Si el RAID es interno y se produce un fallo, en el propio RAID o en otro componente, se pierden los datos. En cambio, si el RAID es externo, aunque falle el servidor los datos seguirán intactos. Luego se conecta el RAID a otro servidor y el trabajo puede continuar sin apenas perder tiempo.
Además, solo el RAID externo permite configuraciones CLUSTER, y al no ser un SISTEMA PROPIETARIO, se puede conectar a cualquier servidor, con independencia de su marca, sin que dé ningún problema ni limite las posibilidades de configuración. Tipos de Cache: Write Back envían al servidor un mensaje de terminación tan pronto como han escrito los datos en la caché. La controladora escribirá los datos en disco a su
conveniencia. De esta forma se mejoran, en definitiva, las prestaciones en escritura. Write Through: En este segundo caso, la controladora escribe los datos a disco y posteriormente manda el mensaje de finalización al servidor. Este proceso de caché resulta más lento que el anterior.
Tipos de Arreglos: #
• Arreglos paralelos: éstos son aquellos en que cada disco participa en todas las operaciones de entrada/salida. Este tipo de arreglo ofrece tasas altísimas de transferencia debido a que las operaciones son distribuidas a través de todos los discos del arreglo y ocurren en forma prácticamente simultánea.
La tasa de transferencia será muy cercana, 95%, a la suma de las tasas de los discos miembros, mientras que los índices de operaciones de entrada/salida serán similares a las alcanzadas por un disco individual. En español: un arreglo paralelo accesará sólo un archivo a la vez pero lo hará a muy alta velocidad. Algunas implementaciones requieren de actividades adicionales como la sincronización de discos. Los RAID de niveles 2 y 3 se implementan con arreglos paralelos.
• Arreglos independientes: son denominados así aquellos arreglos en los cuales cada disco integrante opera en forma independiente, aún en el caso de que le sea solicitado atender varios requerimientos en forma concurrente. Este modelo ofrece operaciones de entrada/salida sumamente rápidas debido a que cada disco está en posición de atender un requerimiento por separado.
De esta forma las operaciones de entrada/salida serán atendidas a una velocidad cercana, 95%, a la suma de las capacidades de los discos presentes, mientras que la tasa de transferencia será similar a la de un disco individual debido a que cada archivo está almacenado en sólo un disco.
Los niveles 4 y 5 de RAID se implementan con arreglos independientes, mientras que los niveles 0 y 1 pueden ser implementados por cualquiera de las categoríías, sin perjuicio de suelan ser implementados en forma de arreglos independientes. Stripping y mirroring RAID a niveles 0, 1 y 0 & 1 puede ser implementado, tanto en forma de arreglos independientes o paralelos.
Conceptos básicos #
• Striping o particionado: técnica de segmentación lógica de los datos que luego son accedidos de forma secuencial en diferentes dispositivos de almacenamiento. Provee un mayor rendimiento en la velocidad de acceso a los datos almacenados en múltiples dispositivos. La falla de un dispositivo causa la perdida de todos los datos. Según lo anterior el porcentaje de falla es la suma del porcentaje de falla de cada dispositivo.
• Mirroring o espejo: técnica en la cual se crean replicas en tiempo real del volumen lógico de un dispositivo en otros dispositivos físicos. Ofrece alta disponibilidad de los datos debido a las múltiples réplicas de los datos (redundancia). De forma adicional provee mejoras en el rendimiento de acceso a los datos (lectura) en múltiples dispositivos. Implementaciones de esta técnica representan un alto costo debido a la réplica de cada dispositivo.
• Parity o paridad: se genera un conjunto de datos de redundancia a partir de dos o más conjuntos de datos primarios aplicando la función Boolena XOR. Con los datos de redundancia se puede reconstruir los datos de algunos de los conjuntos de datos primarios. Aunque no implica duplicar por completo los datos primarios, esta técnica puede ocasionar bajo rendimiento en la velocidad de escritura en un RAID.
• Modo degradado: momento en que un grupo de dispositivos falla por cualquier razón en un RAID (con redundancia). Cuando ocurre funcionamiento no óptimo, redundancia comprometida, suele ocurrir en RAID 1, 5, 10, 50 y 60.
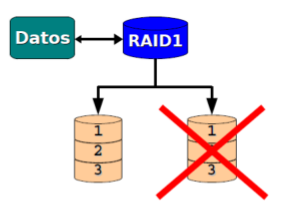
Figura 39. Modo degradado.
• Hot spare o disco sobrante: Es un disco que permanece siempre en el sistema esperando a que uno se estropee y él entre directamente en funcionamiento. Esta característica en niveles con soporte de redundancia permite que RAID se recupere de una falla por si mismo. Soporte tanto en RAID Hardware como Software. El RAID pasa a modo degradado mientras hot spare actúa.
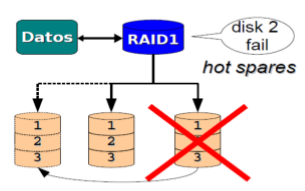
Figura 40. Hot spare.
• Hot swap: Son discos que se reemplazan en caliente. Esto quiere decir que si alguno de los discos RAID se estropeara físicamente bastaría con quitarlo y poner otro sin tener que apagar el sistema. Generalmente se usa en caso de que no se tiene espacio físico para instalar dispositivos con soporte hot spares o cuando un dispositivo en modo hot spare está activo y se debe reemplazar el dispositivo dañado previendo fallas a futuro.
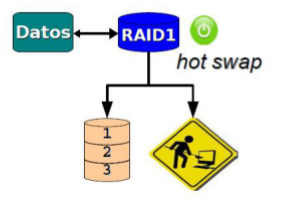
Figura 41. Hot swap.
Niveles RAID #
Son los que determinan las diferentes configuraciones RAID posibles, las cuales van a depender de las necesidades de los usuarios y de las posibilidades de las controladoras. Dichos niveles han sido definidos por el RAID ADVISORY BOARD (RAB). Cada nivel RAID ofrece una combinación específica de tolerancia a fallos (redundancia), rendimiento y coste, diseñadas para satisfacer las diferentes necesidades de almacenamiento.
La mayoría de los niveles RAID pueden satisfacer solamente uno o dos de estos tres criterios.
Los niveles de RAID más usados son: RAID 0, RAID1 y RAID5. También existen niveles RAID anidados, que son la combinación de los niveles RAID normales: RAID 0+1, RAID 1+0, entre otros.
RAID 0: disk striping Tiene la transferencia más alta pero sin tolerancia a fallos. Se utiliza normalmente para incrementar el rendimiento. Los datos se dividen en pequeños segmentos (stripes) de tamaño similar y se distribuyen en varias unidades, estos segmentos son intercalados de manera secuencial y repetida. Al no existir redundancia de datos no hay tolerancia a fallos.
No se considera RAID propiamente dicho, sino un conjunto de unidades de disco conectadas en paralelo que permiten una transferencia simultánea de datos a gran velocidad.
Se necesita un mínimo de dos unidades de disco para implementar esta solución y la capacidad total de almacenamiento es la suma de la capacidad de todos los dispositivos del grupo, se pueden usar dispositivos de diferentes tamaños, recordando que el dispositivo de menor tamaño limita la cantidad de espacio usado en los demás dispositivos. Por ejemplo, tenemos un disco de 40 GB y otro de 80 GB, si hacemos RAID 0 con esos discos, la capacidad total sería 80 GB (40 GB+ 40 GB), perderíamos 40 GB del disco de 80 GB.
Un daño en cualquiera de los dispositivos haría inutilizable el RAID. Este tipo de solución es válida en aplicaciones que requieran un gran RATIO DE E/S, y en las que se puede aceptar la pérdida de algún dato, recomendable su uso en aplicaciones de tratamiento de imágenes, audio, vídeo y prensa. *Una página interesante donde ver las capacidades de cada nivel RAID es: https://www.synology.com/es-es/support/RAID_calculator?
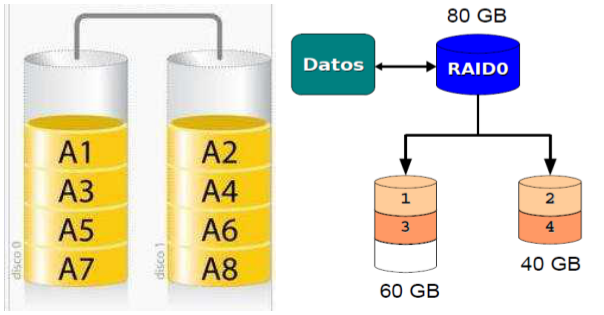
Figura 42. RAID 0.
RAID 1: mirroring Tiene redundancia. Se basa en la utilización de discos adicionales sobre los que se realiza una copia en todo momento de los datos que se están modificando. Se duplican todos los datos de una matriz en otra, con esto se asegura la integridad en los datos y la tolerancia a fallos. Si el disco primario falla el espejo continúa trabajando. Una vez sustituido el disco averiado, los datos se reconstruyen al 100%.
En escritura se pierden prestaciones, al tener que escribir la misma información simultáneamente en dos discos. Por ello, en ocasiones, se utiliza la duplicación de controladoras del disco además de la duplicación de los discos. A este recurso se le denomina DUPLEXING. Dicho recurso resulta caro, ya que requiere instalar en el RAID el doble de la capacidad requerida. En lectura si ofrece mejor rendimiento.
La capacidad total de almacenamiento es igual al tamaño del dispositivo de menor, se necesitan mínimo 2 discos y las unidades se deben añadir a pares.
Su uso se limita a aquellos casos en los que seguridad y continuidad sean fundamentales, como en finanzas, contabilidad, RRHH...
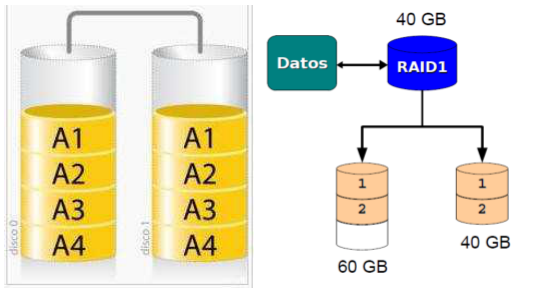
Figura 43. RAID 1.
RAID 2: código Hamming Divide los datos a nivel de bits en lugar de a nivel de bloques, utiliza código Hamming para la corrección de errores. Los discos son sincronizados por la controladora para funcionar al unísono. Permite tasas de transferencia extremadamente altas, aunque actualmente no se usa, ya que las propiedades de código Hamming restringen configuraciones posibles de matrices para el cálculo de paridad de los discos. La segmentación a nivel de bits crea un alto
impacto (lectura/escritura) en los recursos del sistema lo que lo hace inviable a nivel práctico. Necesitaría 39 discos, 32 se usarían para almacenar los bits individuales que forman cada palabra y 7 para la corrección de errores.
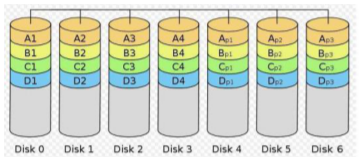
Figura 44. RAID 2.
RAID 3: nivel bytes Acceso síncrono con un disco dedicado a paridad. Usa división a nivel de bytes. Sirve para disponer de redundancia sin tener que recurrir al mirroring. En el RAID 3 se utilizan X discos de datos y un disco adicional dedicado a la paridad. Los datos son divididos en bytes y cada byte se escribe en uno de los X discos de datos. Aplicando un determinado algoritmo se genera el byte de paridad, que se escribe en el disco de paridad. Toda la información se escribe en los discos de forma paralela.
De este modo, la velocidad de transferencia del RAID equivale a la velocidad de transferencia de un disco multiplicada por X. Sin embargo, solo se puede gestionar un E/S a la vez. La recuperación de datos se consigue calculando el O exclusivo (XOR) de la información registrada en los otros discos. Dado que una operación E/S accede a todos los discos al mismo tiempo, el RAID-3 no puede traslapar E/S.
Por esta razón, el RAID-3 es mejor para sistemas de un solo usuario con aplicaciones que contengan grandes registros. Aplicaciones: Producción y distribución de video en streaming, Aplicaciones de imagen, video y Prensa, Servidores de Base de Datos Mono-usuario.
Funcionamiento: Una petición del bloque «A» formado por los bytes A1 a A6 requeriría que los tres discos de datos buscaran el comienzo (A1) y devolvieran su contenido. Una petición simultánea del bloque «B» tendría que esperar a que la anterior concluyese.
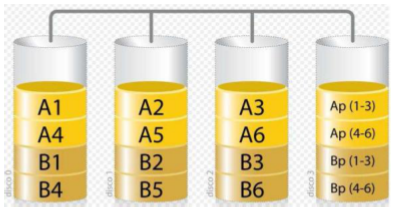
Figura 45. RAID 3.
RAID 4: block striping & dedicated parity Segmenta los datos a nivel de bloques distribuyéndolos entre los dispositivos del RAID. Es un esquema similar a RAID2 y RAID3 pero la división en bloques evita un alto impacto (lectura/escritura) en los recursos del sistema. Acceso independiente con un disco dedicado a la paridad. Basa su tolerancia a fallos en la utilización de un disco dedicado a guardar la información de paridad calculada a partir de los datos guardados en otros discos.
Se necesita un mínimo de tres unidades. La ventaja frente a RAID 3 es que se puede acceder a los discos de forma independiente.
Una petición del bloque «A1» sería servida por el disco 0. Una petición simultánea del bloque «B1» tendría que esperar, pero una petición de «B2» podría atenderse concurrentemente.
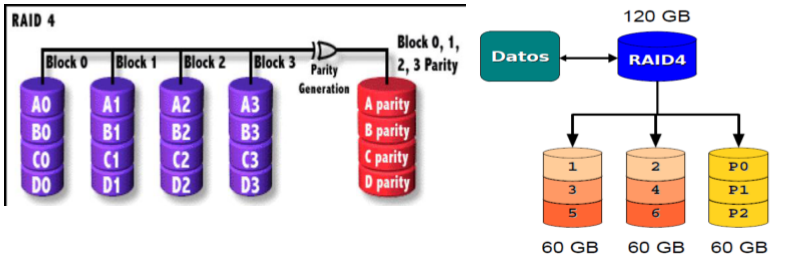
Figura 46. RAID 4.
RAID 5: block striping & distributed parity Segmenta los datos a nivel de bloques distribuyéndolos entre los dispositivos del arreglo de forma similar a RAID 4. Distribuye los datos de paridad entre todos los dispositivos del arreglo. RAID 4 y RAID 5 proveen redundancia ante la falla de un dispositivo en base a la información de paridad. La información del usuario se graba por bloques y de forma alternativa en todos ellos.
Elimina el problema de RAID 4 al no asignar un disco específico para la comprobación, sino que asigna un bloque alternativo de cada disco a esta misión de escritura. Este es el nivel más eficaz y el de uso preferente para las aplicaciones de servidor en la empresa. Ofrece la mejor relación rendimiento- coste en un entorno con varias unidades.
Difiere del RAID 3 en que la información se divide en bloques en vez de en bytes. Debido a ello las lecturas pueden ser independientes, mejorando por tanto el número de transacciones E/S que puede gestionar el RAID de forma simultánea. La otra gran diferencia con el RAID 3 radica en el hecho de que la información de la paridad se reparte entre todos los discos de forma ROTATORIA, aliviando así el cuello de botella que se forma en operaciones simultáneas de E/S.
Esto ocurre, en concreto, gracias a que solo se debe leer la paridad de un único disco, como es
el caso del RAID 3. Con lo que resuelve las limitaciones de escritura en RAID-4. Así, todas las operaciones de lectura y escritura pueden superponerse.
Gracias a la combinación del fraccionamiento de datos y la paridad como método para recuperar los datos en caso de fallo, constituye una solución ideal para los entornos de servidores en los que gran parte de E/S es aleatoria, la protección y disponibilidad de los datos es fundamental y el coste es un factor importante.
Esta especialmente indicado para trabajar con sistemas multiusuario y también recomendable para aplicaciones que trabajen con ficheros pequeños pero con un gran número de transacciones E/S, como es el caso de las bases de datos relacionales o las aplicaciones de gestión. Aplicaciones: Servidores de archivos y aplicaciones, Servidores de Base de Datos, Servidores www, correo, noticias, Servidores de Intranet.
Se necesita un mínimo de tres unidades de disco para implementarlo, aunque su resultado óptimo de capacidad se obtiene con siete o más unidades.
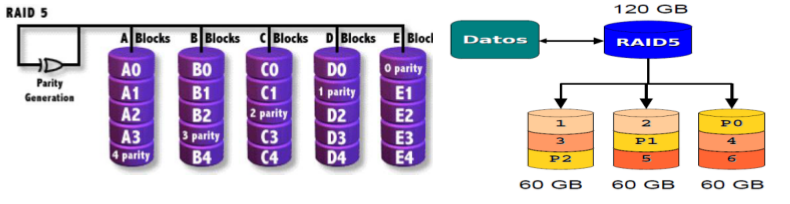
Figura 47. RAID 5.
RAID 6: block striping & doble distributed parity Acceso independiente con doble paridad. Parecido al RAID 5, pero incluye un segundo esquema de paridad distribuido por los diferentes discos, por lo que ofrece tolerancia extremadamente alta a los fallos y las caídas de disco, ofreciendo dos niveles de redundancia. Su coste de implementación es muy alto por eso casi no se implementa. Un segundo conjunto de datos de paridad lo que provee redundancia ante la falla de dos dispositivos.
Hay pocos ejemplos comerciales en la actualidad. Posee un diseño muy complejo, un rendimiento pobre y se necesitan N+2 discos.
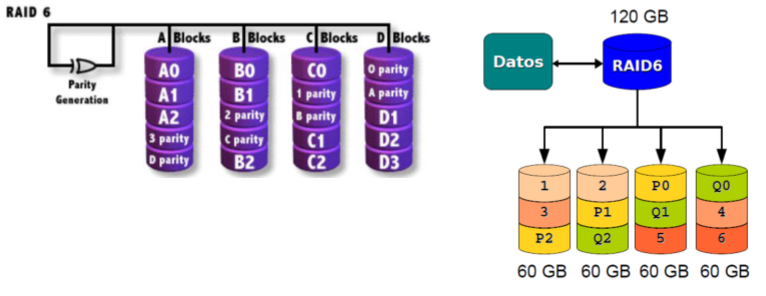
Figura 48. RAID 6. RAID 7 Este tipo incluye un sistema operativo incrustado de tiempo real como controlador, haciendo las operaciones de caché a través de un bus de alta velocidad y otras características de un ordenador sencillo. Todas las transferencias son asíncronas. Y las E/S están centralizadas
por la caché. Se necesita un disco de paridad exclusivo. El agente SNMP permite su administración remota. Aplicaciones: Sistemas de Tiempo Real (Industriales).
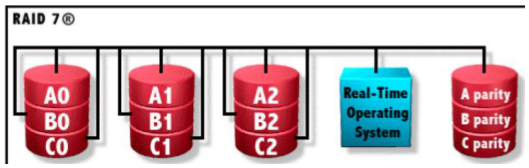
Figura 49. RAID 7.
RAID 0+1: stripping & mirroring Consiste en la duplicación de los datos en diferentes conjuntos de discos, para un posterior stripping dentro de cada uno de dichos conjuntos. Utiliza un poco de cada uno lo que proporciona velocidad y tolerancia a fallos. Fracciona los datos para mejorar el rendimiento mientras que utiliza un conjunto de discos duplicados para conseguir redundancia de datos. Requiere un mínimo de cuatro unidades, sólo dos de ellas se utilizan para el almacenamiento de datos.
Este nivel está indicado para aplicaciones que necesiten altas prestaciones y un alto nivel de seguridad. Aplicaciones: Aplicaciones de Imagen, Servidores de archivos generales.
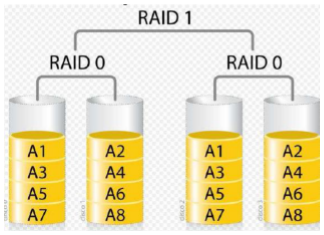
Figura 50. RAID 0+1.
RAID 1+0: mirroring & striping Este nivel ofrece un conjunto de bandas en el que cada banda es un grupo de discos RAID-1. Esto proporciona mejor rendimiento que el RAID-1, pero a un costo mucho mayor. A pesar de su alto costo es muy utilizado. Combina el rendimiento (velocidad de acceso) de la segmentación de datos (striping) con las propiedades de la redundancia (mirroring). Si un dispositivo falla ambos lados del RAID 10 seguirán funcionando (aunque un lado en modo degradado).
Aplicaciones: Servidores de Bases de Datos con alto rendimiento y tolerancia a fallos.
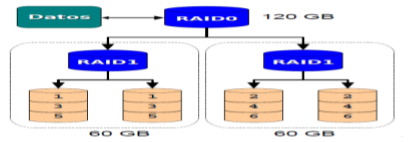
Figura 51. RAID 1+0. RAID 5+0: striping & parity En referencia a un RAID 10:
• Menor costo.
• Rendimiento de lectura más bajo (aunque sigue siendo bueno).
• A nivel de escritura hay mayor rendimiento (velocidad).
• Cada RAID 5 puede soportar la falla de un dispositivo.
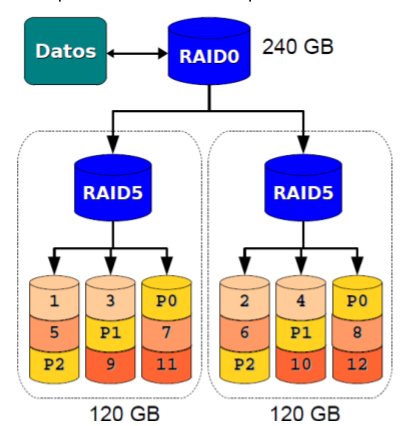
Figura 52. RAID 5+0.
RESUMEN NIVELES: #
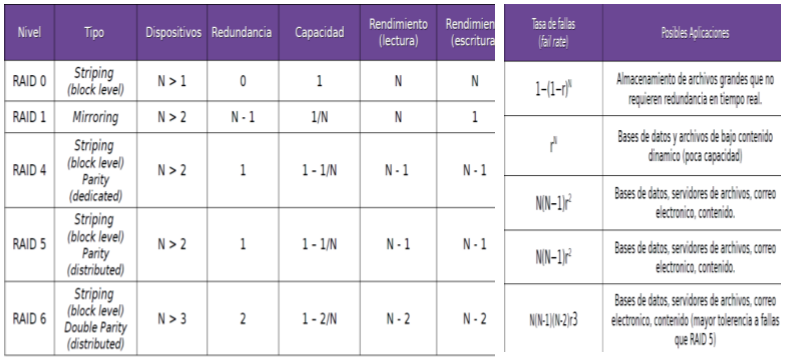
N = Cantidad de dispositivos en el grupo de almacenamiento
r = % de error estimado por cada dispositivo del grupo de almacenamiento.
VIP!!! Sobre los niveles RAID, para calcular capacidad:
RAID 0= N*(CAPACIDAD DEL MENOR MIEMBRO RAID)
RAID 1= N/2*(CAPACIDAD DEL MENOR MIEMBRO RAID)
RAID 5= (N-1)*(CAPACIDAD DEL MENOR MIEMBRO RAID)
RAID 6= (N-2)*(CAPACIDAD DEL MENOR MIEMBRO RAID)
Implementación en Linux #
Verificando que dispositivos están instalados y como están distribuidos:
# fdisk /dev/sdaUsando herramientas de RAID en Linux, herramienta MDADM:
# apt-get install mdadmCreando un arreglo:
# mdadm -C /dev/md0 -a yes -l 0 -n 2 /dev/sda10 /dev/sda11Dando formato a un arreglo:
# mkfs.ext3 /dev/md0Definiendo en el arranque:
# vim /etc/fstab/dev/md0 /usr2 ext3 defaults 0 0# rebootMonitoreo de los arreglos:
# cat /proc/mdstat# mdadm –-detail /dev/md0Chequeando el arreglo:
Simulando una falla en un disco:
# mdadm /dev/md0 -f /dev/sda1Restableciendo una falla en un disco:
# mdadm /dev/md0 -r /dev/sda1Mas documentación
# man mdadm JBOD (Just a Bunch of Disks) #
JBOD es el acrónimo de Just a Bunch of Disks (Un mero puñado de discos). En esta configuración, cada unidad se considera un dispositivo independiente, de forma similar a las unidades de disco duro independientes. Todos los discos aparecerán en su ordenador como discos duros individuales, divididos en las particiones creadas por la utilidad de gestión de discos del sistema operativo. Una gran ventaja de JBOD es el uso de la capacidad completa de ambas unidades.
Asimismo, en caso de fallo de una de las unidades, no se pierden los archivos almacenados en la unidad correcta. Sin embargo, esta configuración no proporciona ninguna de las ventajas de RAID 0 (velocidad) ni RAID 1 (protección de datos completa). La capacidad total de una matriz JBOD es la suma de capacidades de cada uno de sus discos, o C = n*d donde: C = capacidad disponible n = número de discos d = capacidad de disco.
Por ejemplo, en una matriz JBOD con cuatro unidades de 1000 GB de capacidad cada una, la capacidad total de la matriz sería de 4000 GB: C = (4*1000).
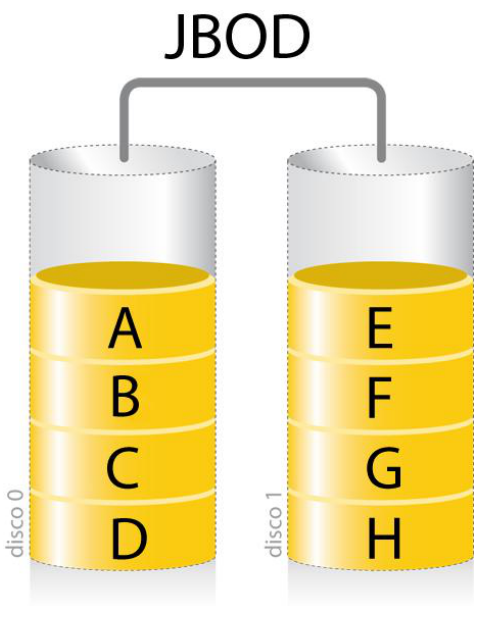
Figura 53. JBOD.